返回全部教程
2026-10-10
AI 宝宝唱歌视频生成器
上传清晰的宝宝照片,添加自己的音频或示例片段,再选择模型生成。AI 会根据音频匹配嘴部动作,让照片呈现唱歌的效果。
让照片演唱你已经准备好的录音。这是唱歌对口型流程:根据音频驱动面部,不负责作曲、翻译歌词,也不会把成人歌声变成婴儿声音。
打开工具快速步骤
从准备素材到检查结果,按顺序完成。
- 1打开宝宝唱歌工具。
- 2上传清晰的正面宝宝照片,确保光线良好、面部无遮挡。
- 3选择 Pruna AI Avatar 或 Kling Avatar,再上传音频或选择示例。Pruna 最长支持 180 秒,Kling Avatar 最长支持 60 秒;文件上限为 20 MB。
- 4选择 720p 或 1080p。生成前查看按模型、分辨率和音频时长计算的预计积分。
- 5生成后检查口型与声音是否协调。
- 6下载完成的视频。这里没有单独的画面比例选项,请提前准备合适构图的照片,或在下载后裁剪。
当前可选参数
分辨率:720p1080p
先用一句完整歌词做测试
- 选择人声清楚的片段
- 找一段只有一个清楚主唱的短句。10–15 秒适合初次测试,避免很长的纯音乐前奏、多人重叠演唱,或伴奏盖住歌词。
- 剪辑时不要切掉字头字尾
- 在音频编辑器中,给第一个音节前和最后一个音后留一点余量。去掉长静音,但不必删掉每次呼吸。完整播放导出文件,检查最大音量处是否失真。
- 歌曲语言由录音决定
- 上传的人声决定歌词、语言和音色。想换语言或歌手,需要先准备另一份录音。更改页面语言,或在提示词中写译文,都不会替换音频。
可以自己演唱的一句歌词
送你一首小小的歌,愿你每天笑着过。
可以用自己的旋律演唱这句原创歌词,再上传或录制音频。这是录音素材,不是让编辑器自动演唱的文字提示词。
选择照片之前,先听音频
这是编辑器中提供的 astrogalaxymoon13s.mp3 短示例,可用来了解初次测试的长度。它并不是下方三个历史视频已记录的原始音频。
摇篮曲适合表情平静、嘴唇放松的肖像;活泼祝福可在脸颊和头部四周多留空间。麦克风、手和玩具不要挡嘴。照片中的麦克风只是场景元素,并非让照片唱歌的必需品。
上传素材,选择模型并确认费用
- 文件与模型限制
- 上传一张最大 10 MB 的 PNG、JPG 或 WebP,以及最大 20 MB 的音频。支持 MP3、WAV、M4A、AAC 和 OGG。默认 Pruna AI Avatar 最长支持 180 秒,Kling Avatar 最长支持 60 秒。切换模型不会自动剪短音频。
- 分辨率与时长
- 当前两个模型都提供 720p 和 1080p。可先用 720p 检查嘴部,更高分辨率不能修复同步问题。时长取自音频,并向上取整计算估算费用;这里没有独立时长或比例选择器。
- 可选的表演要求
- 可以用“表情柔和,头部轻微移动,镜头稳定”等简短提示词描述表演。它不会编写歌词或创造新旋律。生成前确认识别时长、分辨率和积分。
教程案例:素材、提示词与参数
对照案例、可用输入素材和已记录的设置。
案例 1
宝宝唱歌片段(历史 480p 案例)
如何参考这个案例
这些是历史唱歌案例,标签说明原始文件规格,不代表当前可选分辨率。使用照片和自己的歌曲或示例音频制作时,应观看完整片段,检查口型和人声。
输入素材
.webp)
输入素材 1
该案例记录的设置
画面比例
9:16
使用 Kling Avatar 生成。
- 带麦克风的近景肖像
- 金发孩子的脸占据大部分画面,便于对照原图观察嘴唇和脸颊。实际文件为 640 × 640、13.44 秒;旧标签中的 480p/9:16 并非真实尺寸或当前设置。这个案例是年龄较大的儿童,并非婴儿。
案例 2
宝宝唱歌片段:案例 2
如何参考这个案例
这些是历史唱歌案例,标签说明原始文件规格,不代表当前可选分辨率。使用照片和自己的歌曲或示例音频制作时,应观看完整片段,检查口型和人声。
输入素材
.webp)
输入素材 1
该案例记录的设置
画面比例
9:16
使用 Kling Avatar 生成。
- 脸部稍微抬起
- 第二个孩子在麦克风旁向上看。720 × 720、13 秒结果中,应检查头部移动时闭嘴动作是否仍然清楚。自己的照片也应让麦克风避开嘴唇。
案例 3
宝宝唱歌片段(720p)
如何参考这个案例
这些是历史唱歌案例,标签说明原始文件规格,不代表当前可选分辨率。使用照片和自己的歌曲或示例音频制作时,应观看完整片段,检查口型和人声。
输入素材
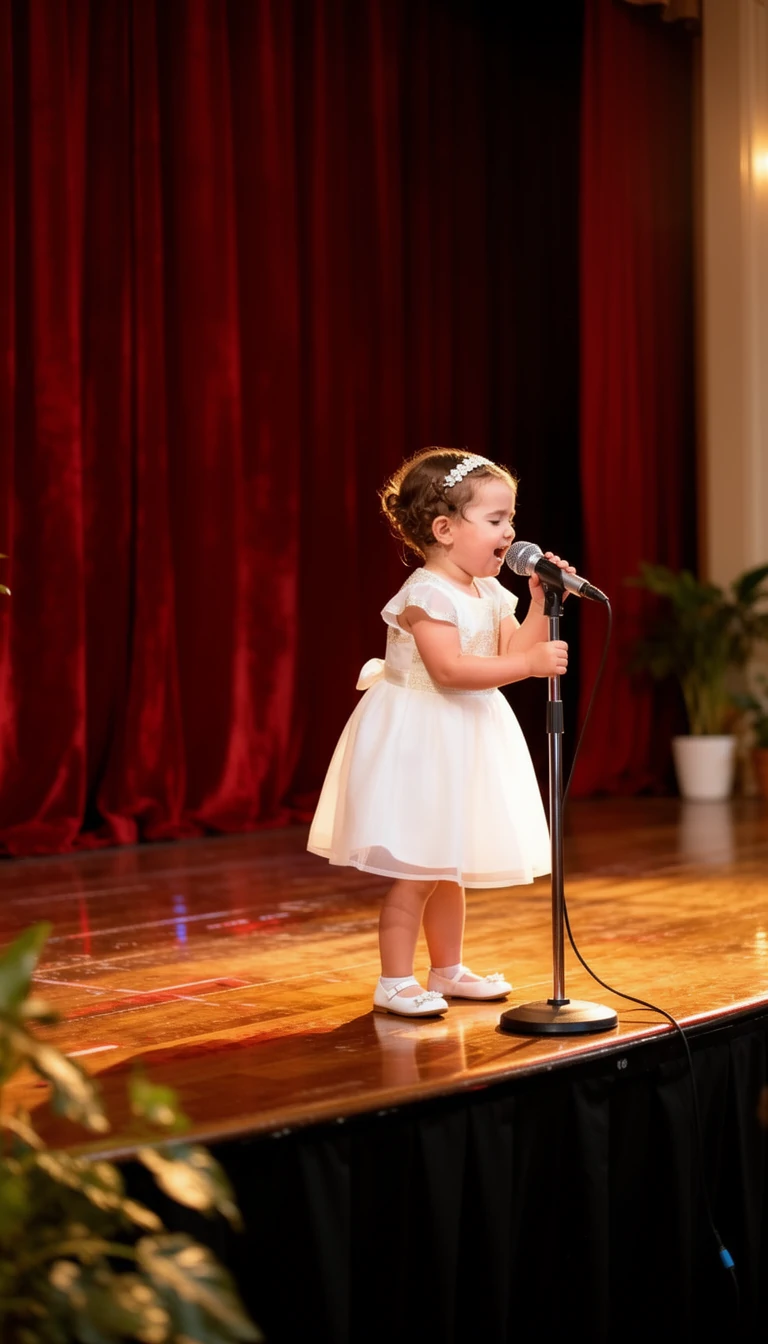
输入素材 1
该案例记录的设置
画面比例
9:16
使用 Kling Avatar 生成。
- 舞台氛围与嘴部细节的取舍
- 白裙舞台场景为 452 × 720,约 12.2 秒,展示了更多身体和环境,但脸部更小。适合比较构图,不能据此认定口型比近景更准确。
检查第一个音节、持续音和最后停顿
下载可用版本并试听实际文件。歌词字幕、标题或结尾祝福需要在视频编辑器添加,唱歌工具没有字幕开关。检查人名和换行,文字不要挡嘴;如果结果已有声音,不要再次叠加原音频导致人声重复。这三个历史案例没有附带独立原音频,不能用作同条件模型对比。
- 嘴部开始太晚
- 先听原音频:人声前是否有静音或长呼吸?只剪掉不需要的部分。如果录音本身就缺少第一个音节,应重新录制或选择更完整的片段。
- 纯伴奏时嘴还在动
- 尝试人声更清楚、伴奏更轻的短句。模型未必能准确识别每个音乐停顿。更换音频时保持照片不变,便于比较节奏。
- 长音时面部发生变化
- 在持续音和收音过程中观察眼睛、下颌和脸颊。可试更清晰、更正面的照片,或缩短片段。测试新照片时保持音频不变。
制作建议
- 使用五官清楚、对焦准确的正面宝宝照片,更便于匹配口型。
- 先尝试 10–30 秒的短音频,便于检查自然程度。
- 先用 720p 测试一小段,再制作较长的表演。选择 1080p 会改变预计积分,每次切换模型或设置后都应重新确认。
- 避免嘈杂录音或过快的演唱,优先使用人声清晰、节奏适中的音频。
- 发布到社交平台时,可添加字幕和相关话题标签。
常见问题
支持哪些音频格式?▼
支持 MP3、WAV、M4A、AAC 和 OGG,文件最大 20 MB。时长上限取决于模型:Pruna AI Avatar 为 180 秒,Kling Avatar 为 60 秒。
宝宝唱歌视频应该选什么分辨率?▼
当前编辑器提供 720p 和 1080p。请比较实时积分估算,不要沿用历史案例中的 480p 价格。最终效果也取决于照片和音频质量。
为什么口型对不上?▼
常见原因包括照片模糊、面部被遮挡或音频速度过快。尝试更清楚的照片和语速较慢、杂音较少的音频。
可以用自己的音乐吗,还是只能用示例?▼
两者都可以。你可以上传自己的音频文件,也可以选择内置示例片段,例如儿歌或流行歌曲。
什么照片适合制作宝宝唱歌视频?▼
选择清楚、光线均匀的正面宝宝照片,嘴部应可见,避免奶嘴、手或玩具挡住面部。
可以输入歌词,让工具自动创作歌曲吗?▼
这个编辑器需要录音,不会作曲,也不会把输入歌词变成歌声。请先录下自己的演唱或准备音频文件;可选提示词只描述视觉表演。
歌声会自动变成宝宝的声音吗?▼
不会。声音来自上传音频,让宝宝照片动起来不会把成人歌声转换成婴儿音色。请先准备好需要的声音,再上传。
可以让宝宝唱其他语言的歌吗?▼
上传用该语言演唱的录音即可,界面语言不会翻译歌曲。使用长音轨前,先用短片核对具体音节和口型节奏。
准备开始制作?
选择自己的素材,生成前检查当前可用设置。